Przejdź do treści

Otwarty na etat

Full stack developer i inżynier AI. Buduję cały produkt, nie jego wycinek.

Osiem lat wdrażania oprogramowania od 2018 roku, w tym pięć lat prowadzenia własnych produktów. Vue i Nuxt na froncie, Node i serverless pod spodem, przepływy LLM tam, gdzie naprawdę mają sens — a do tego model danych, wdrożenie, SEO i koszty AI.

300K+
zamówień obsłużonych na platformie, którą zbudowałem i prowadziłem
10,000
zarejestrowanych użytkowników produktu AI w architekturze serverless
90%
codziennych operacji zautomatyzowanych
Każda warstwa, jeden inżynier
Interfejs
Vue.jsNuxtTypeScriptAngularTailwind
API i usługi
Node.jsExpressREST APIsServerless
Warstwa AI
LLM APIsAgentsRAGMCPEvals
Dane
PostgreSQLMySQLMongoDBFirebase
Infrastruktura
VercelDockerCI/CDCapacitor
Produkt i wzrost
SEOAnalyticsGoogle AdsCRO

W większości projektów odpowiadałem za kilka z tych warstw naraz — od modelu danych po wdrożenie.

Stack

Po co sięgam na co dzień.

Vue.js Nuxt TypeScript Angular Tailwind CSS CapacitorJS Node.js Express PHP WordPress Java REST APIs Stripe LLM APIs RAG Reranking LangChain MCP Prompt caching Context compression Evals PostgreSQL MySQL MongoDB Firebase Vercel Serverless Docker Git SEO
Popracujmy razem

Moje umiejętności

Warsztat, według kategorii.

Osiem lat wdrażania, sprowadzone do narzędzi, po które naprawdę sięgam — pogrupowane według dziedziny i ocenione w skali od jednego do pięciu. Kropki to moja własna, uczciwa samoocena, a nie certyfikat.

Frontend

09
  • Vue.js
  • JavaScript
  • HTML
  • Nuxt
  • CSS
  • TypeScript
  • SCSS / Sass
  • Angular
  • CapacitorJS

Backend

09
  • Node.js
  • REST APIs
  • Express
  • Serverless
  • Stripe
  • Payment gateways
  • WordPress
  • PHP
  • Java

AI & LLM

09
  • LLM APIs
  • RAG
  • Context compression
  • Prompt caching
  • MCP
  • AI agents
  • Model routing
  • Evals
  • LangChain

Databases

03
  • MySQL
  • Firebase
  • NoSQL

DevOps & Infra

04
  • Git
  • Vercel
  • Docker
  • CI/CD

Growth & Business

07
  • SEO
  • Client management
  • Customer support
  • Analytics
  • Google Ads
  • TikTok Ads
  • CRO

Czym się zajmuję

Trzy rzeczy, robione porządnie.

Większość współprac zaczyna się od jednej z nich, a kończy na wszystkich trzech — i zwykle właśnie o to chodzi.

Od pustego repozytorium do czegoś, co działa na produkcji

Full Stack Development

Doprowadzałem produkty od pustego repozytorium do setek tysięcy realnych transakcji — frontend, API, baza danych, infrastruktura, wdrożenia i awaria o trzeciej w nocy. W Vue i Node czuję się jak w domu; wdrażałem też Angulara, PHP i aplikacje mobilne.

Jak do tego podchodzę
  • Frontendy Vue.js / Nuxt — dostępne, szybkie, z typowaniem od API po UI
  • API w Node.js / Express oraz funkcje serverless na Firebase i Vercel
  • WordPress i PHP tam, gdzie uzasadnia to biznes, zintegrowane z nowoczesnym JS
  • Aplikacje mobilne z tej samej bazy kodu co web, opublikowane w obu sklepach
  • Modelowanie danych SQL i NoSQL, integracje płatności oraz SEO, dzięki któremu produkt da się znaleźć
  1. Zaczynam od transakcji

    Szukam tego jednego przepływu, który zarabia, i buduję wokół niego całą resztę. Wszystko inne jest tylko rusztowaniem.

  2. Celowo nudna architektura

    Usługi zarządzane, mało ruchomych części, jedno środowisko wdrożenia. Złożoność to koszt płacony co tydzień, a nie raz.

  3. Wdrażam wąskimi pionowymi kawałkami

    Każdy taki kawałek przechodzi przez UI, API i bazę aż na produkcję. Problemy integracyjne wychodzą w pierwszym tygodniu, a nie w trzecim miesiącu.

  4. Automatyzuję operacje

    Jeśli człowiek robi coś dwa razy dziennie, zamieniam to w skrypt. Ten nawyk sprawił, że rosnącą platformę mogły prowadzić dwie osoby.

Powiązane realizacje
Agenci i pipeline'y, które wytrzymują produkcję

AI Workflow Development

Demo, które zadziałało raz, to jeszcze nie workflow. Buduję systemy LLM razem z ich nudnymi częściami: wyszukiwaniem, które zwraca właściwy fragment, narzędziami z prawdziwą obsługą błędów, etapami ustawionymi tak, by drogie wywołanie było ostatnie, i planem awaryjnym dla każdego kroku, który może zawieść.

Jak do tego podchodzę
  • Projektowanie agentów i pipeline'ów — planowanie, użycie narzędzi, etapowanie i wiedza, kiedy przestać
  • Architektury RAG z rerankingiem, strategią chunkowania i kompresją kontekstu
  • Serwery MCP: otypowane narzędzia, stabilne schematy, rozliczanie na granicy systemu
  • Bezpośrednia integracja z API dostawców, bez chowania się za frameworkiem
  • Punkty kontrolne z udziałem człowieka wszędzie tam, gdzie w grę wchodzą pieniądze lub klienci
  1. Mapuję decyzję, nie prompt

    Zanim wywołam jakikolwiek model, spisuję, co system decyduje, co wolno mu zrobić i co się dzieje, gdy się pomyli. Większość nieudanych projektów AI pominęła ten krok.

  2. Buduję najmniejszą uczciwą wersję

    Jedna ścieżka, prawdziwe dane, żadnego frameworka do orkiestracji. To natychmiast obnaża problemy z wyszukiwaniem i jakością danych — a tam właśnie jest cała robota.

  3. Układam pipeline według kosztu

    Najpierw tanie, deterministyczne sygnały; drogie wywołanie multimodalne tylko na tym, co przetrwa. To kolejność decyduje, czy powstaje produkt, czy demo, na które cię nie stać.

  4. Uszczelniam brzegi

    Timeouty, ponowienia z backoffem, walidacja schematu na każdym wyjściu modelu i deterministyczny plan B. Model jest komponentem, a nie systemem.

Powiązane realizacje

Ten sam efekt, ułamek pracy i kosztów

Automatyzacja i inżynieria kosztów

Dwie wersje tego samego nawyku: znaleźć pracę, która się powtarza, i przestać za nią płacić. Na platformie e-commerce oznaczało to automatyzację około 90% codziennych operacji. W produkcie AI — obniżenie kosztu inferencji o 80% bez zmiany oferowanych modeli.

Jak do tego podchodzę
  • Inżynieria kontekstu — retrieval, reranking i kompresja, żeby model czytał to, co istotne, i nic więcej
  • Cache promptów i dobór modelu do zadania, mierzone względem bazowego poziomu jakości
  • Automatyzacja operacji: przyjęcie, walidacja, wysyłka i uzgadnianie statusów bez udziału człowieka
  • Alerty na wyjątkach zamiast pilnowania happy path
  • Decyzja człowieka zostawiona dokładnie tam, gdzie naprawdę potrzeba oceny
  1. Najpierw liczę, potem ruszam

    Które procesy się powtarzają, ile zjadają godzin, dokąd faktycznie idą tokeny. Rachunek i obciążenie prawie nigdy nie rozkładają się tak, jak zakłada zespół.

  2. Najpierw naprawiam kontekst

    Najtańsza optymalizacja to nie wysyłać tokenów, których nie potrzebowałeś. Zbyt duże prompty i niefiltrowany retrieval to zwykle główni winowajcy — stamtąd wzięła się większość tych 80%.

  3. Automatyzuję w kolejności zaoszczędzonych godzin

    Porządkuję ręczne operacje według czasu, jaki zjadają, i schodzę po liście. Pierwsze trzy zwykle spłacają cały projekt.

  4. Eskaluję wyłącznie wyjątki

    Automatyzacja obsługuje wolumen, ludzie — ocenę sytuacji. Zwroty, spory i wszystko niejednoznaczne nadal trafia do człowieka — reszta chodzi bez nadzoru.

Wybrane realizacje

Co zbudowałem i w jaki sposób.

Każde studium przypadku zawiera architekturę, którą faktycznie wdrożyłem — nie jej wygładzoną wersję.

Wszystkie studia przypadków
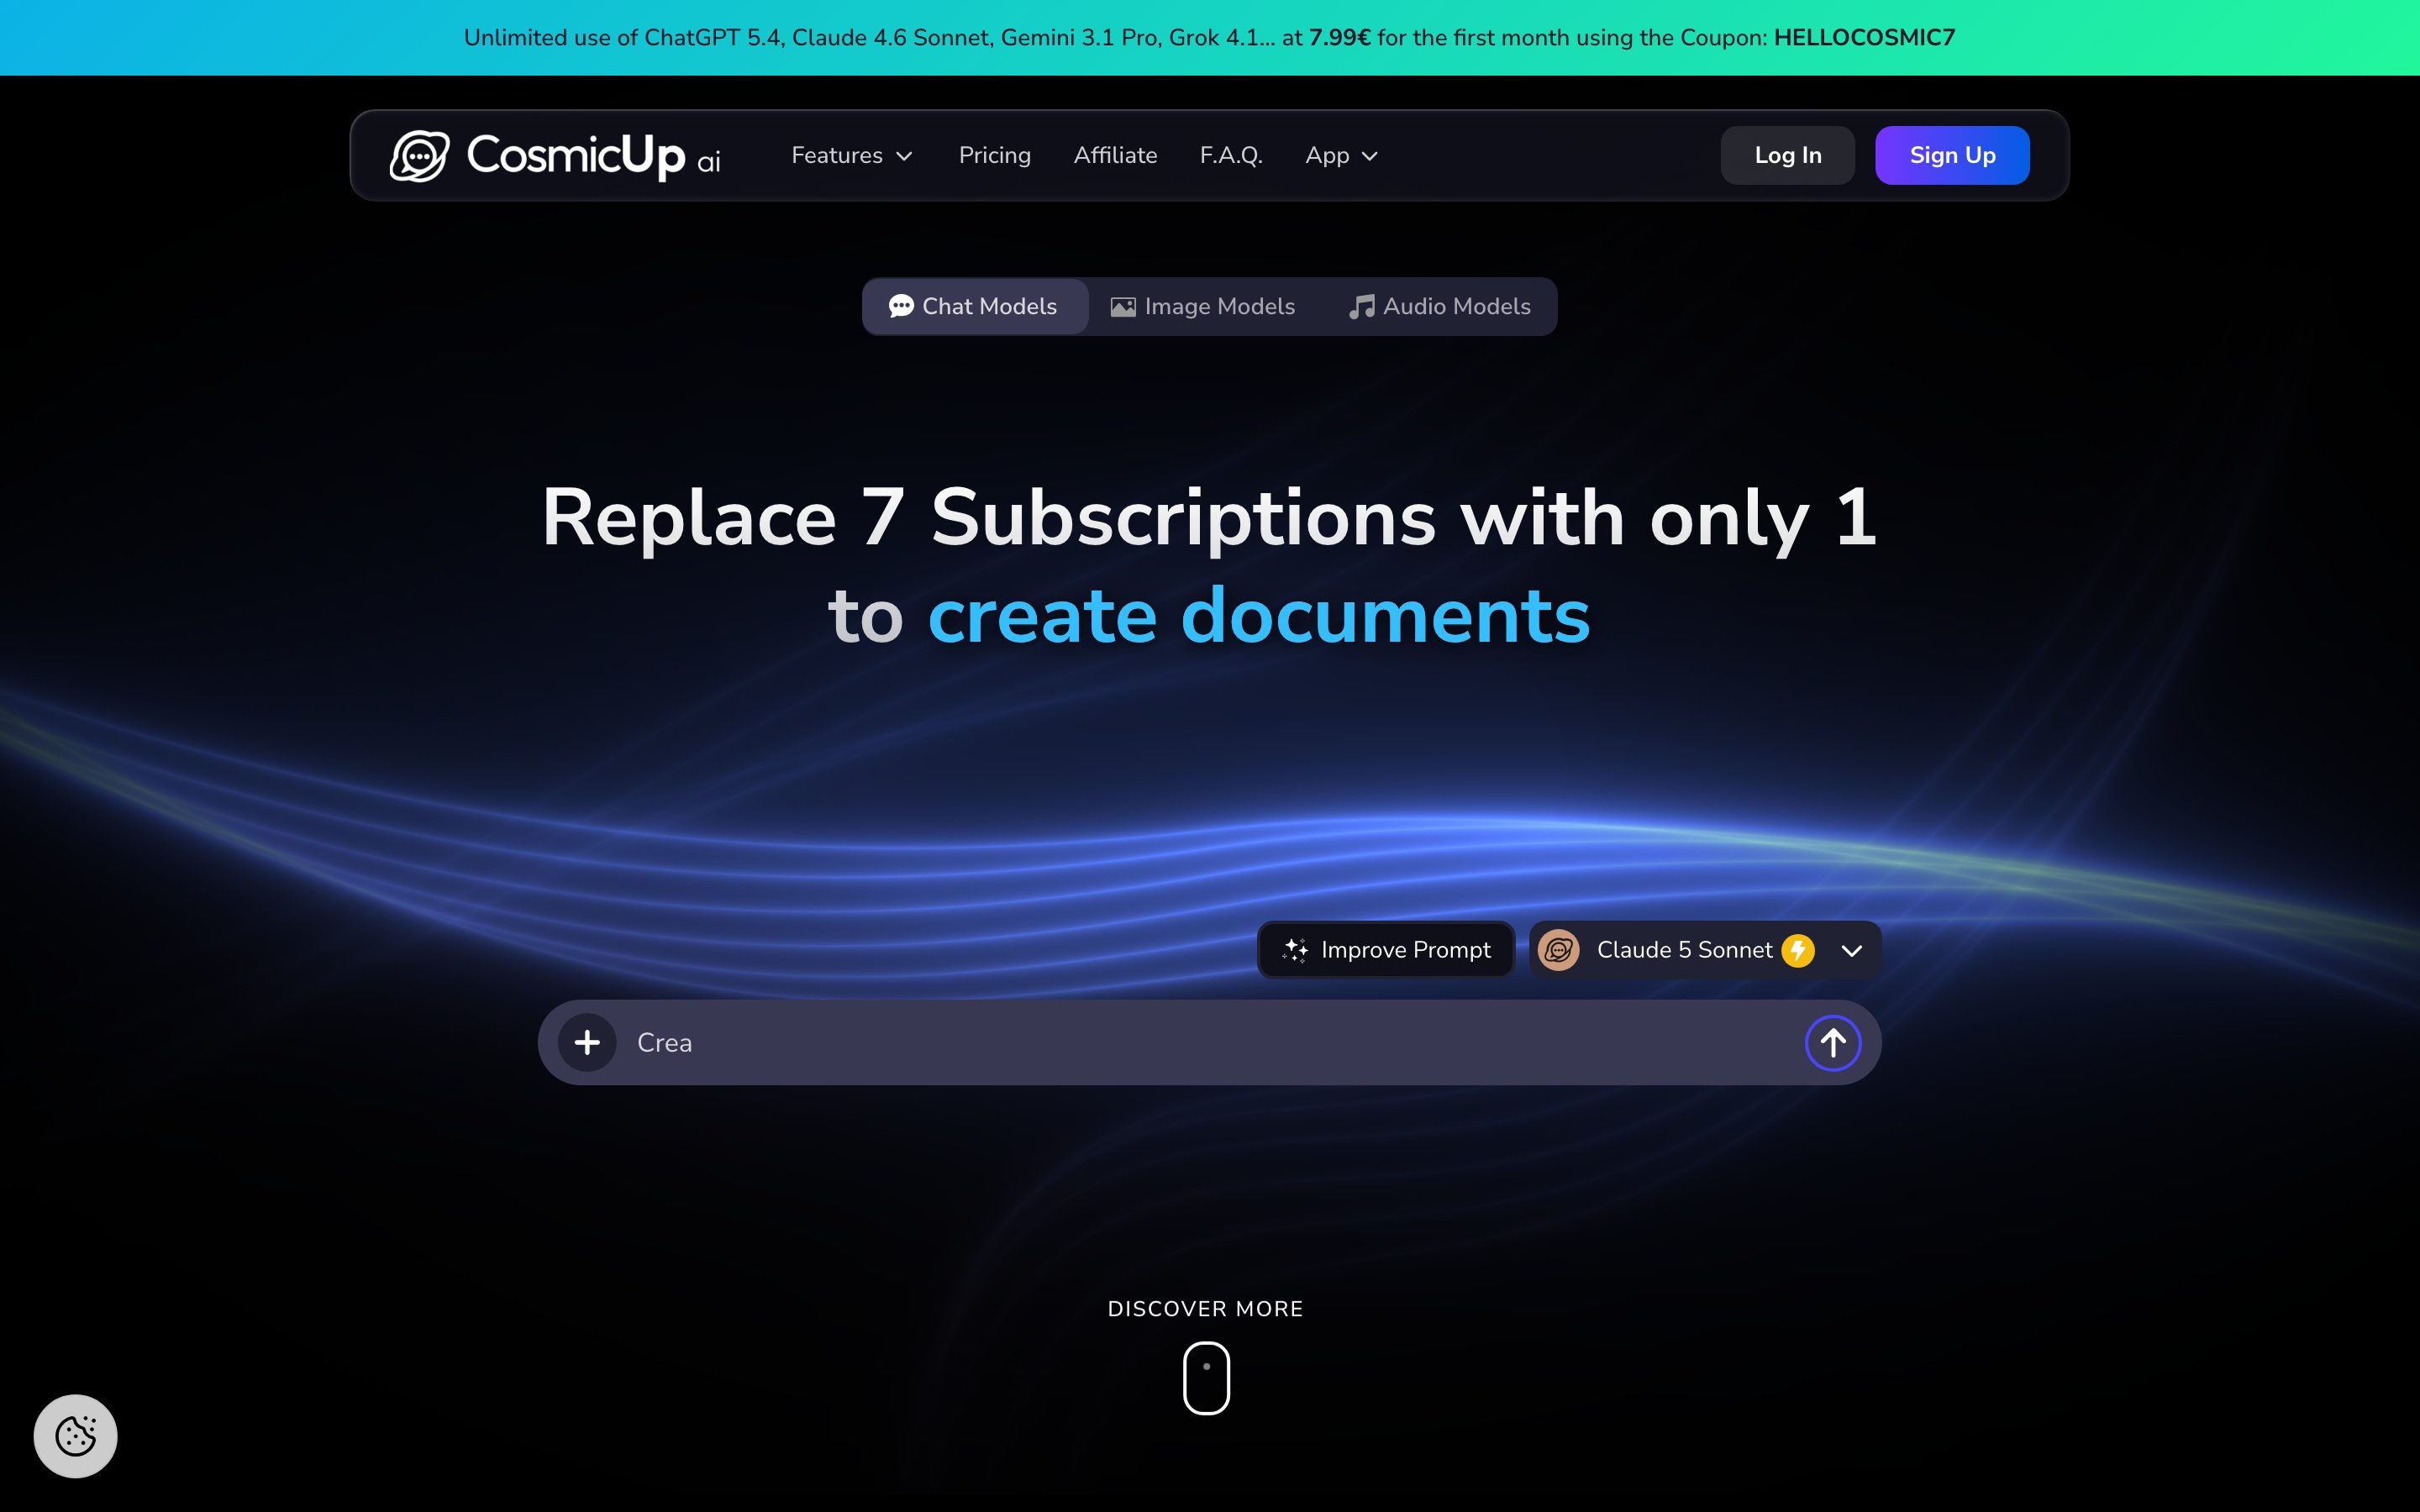
Zrzut ekranu strony głównej CosmicUp.me
012024 — 2026

CosmicUp.me

LumaUp sp. z o.o.

Współzałożyciel · produkt i inżynieria

Zamiast siedmiu subskrypcji AI jedna — 30+ modeli, 10 000 użytkowników, 80% niższy koszt inferencji.

CosmicUp daje ponad 30 modeli tekstowych, graficznych i audio w jednej subskrypcji za 16,99 €/mies. — w przeglądarce, na iOS i na Androidzie. Trudny nigdy nie był interfejs, tylko obsługa nierównego ruchu inferencyjnego przy stałej cenie, gdzie każda decyzja architektoniczna jest też decyzją o marży. Każdy dostawca jest zintegrowany przez własne API, bez spłaszczania do wspólnej bramki, więc szerokość katalogu zostaje nienaruszona. Dźwignia leży przed wywołaniem modelu: retrieval, reranking, kompresja kontekstu i prompt caching obniżyły koszt inferencji o około 80%. Limity fair use nie odcinają użytkownika — przenoszą go do wolniejszej kolejki.

10,000
zarejestrowanych użytkowników
30+
dostępnych modeli
−80%
koszt inferencji po pracy nad kontekstem
Vue.jsNode.jsFirebaseServerlessLLM APIsRAG
Przeczytaj studium przypadku
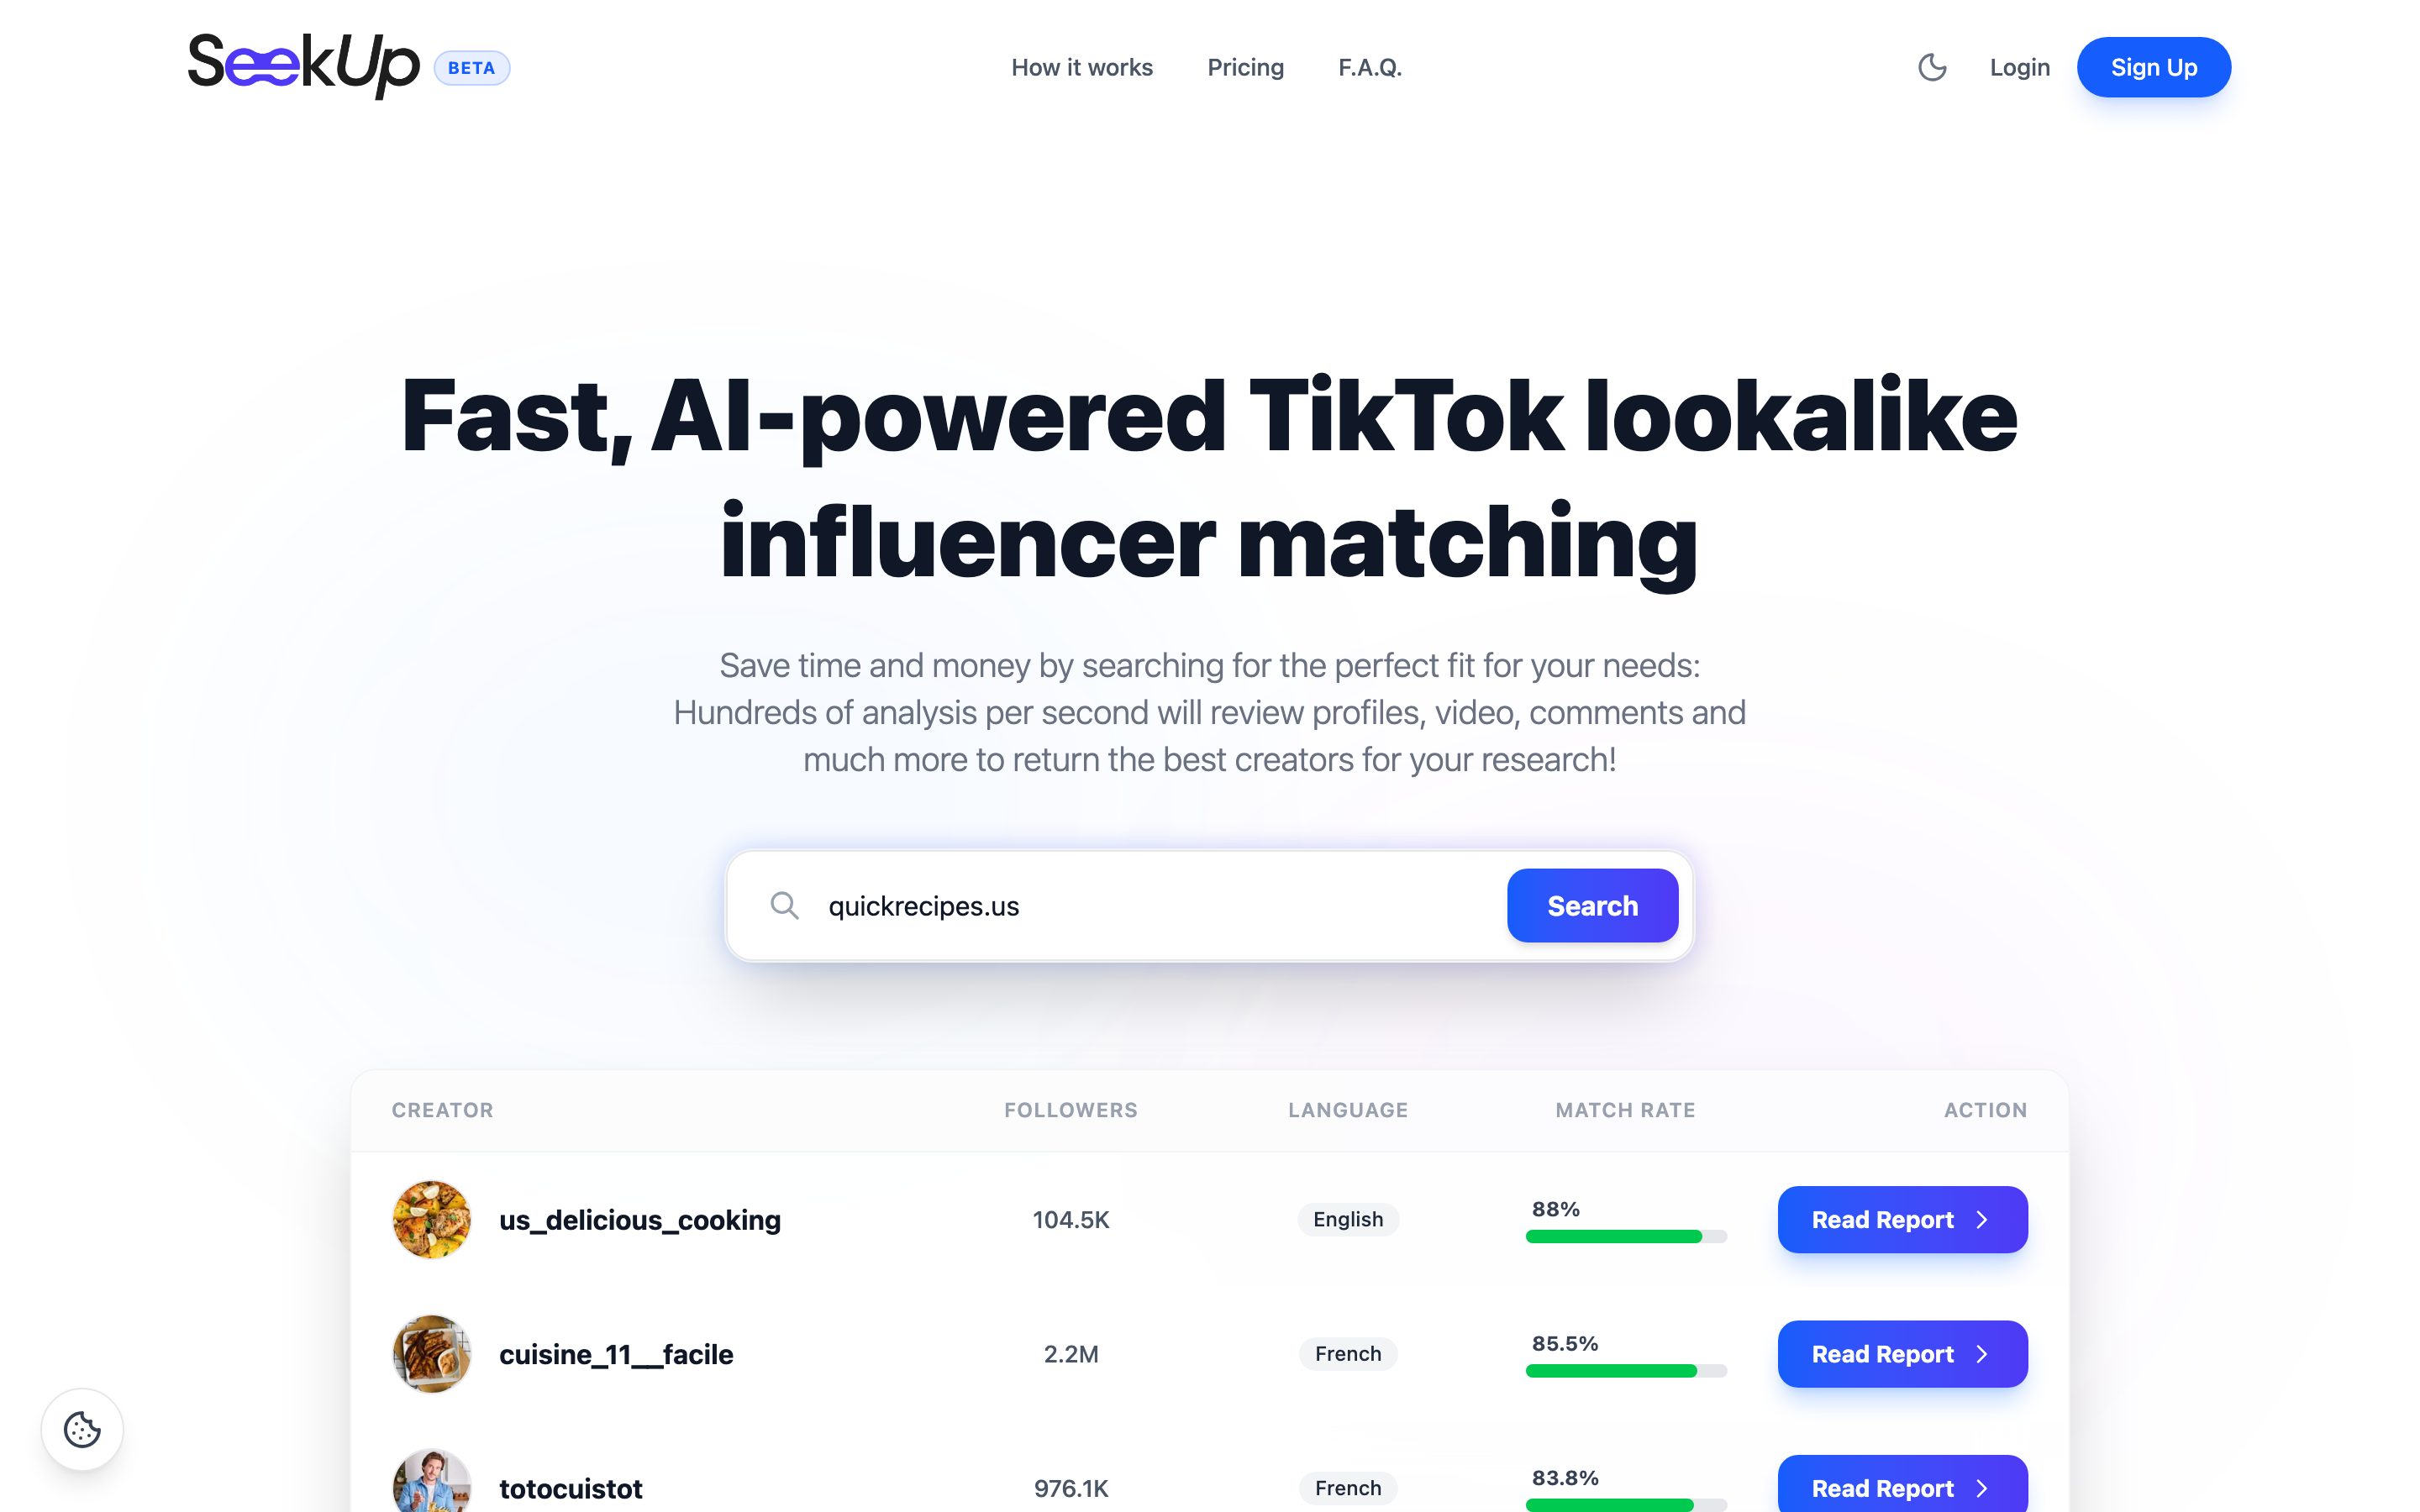
Zrzut ekranu strony głównej SeekUp.ai
022025 — 2026

SeekUp.ai

LumaUp sp. z o.o.

Produkt i inżynieria

Wskaż jednego twórcę na TikToku, który działa, a dostaniesz dziesięciu, którzy działają podobnie.

SeekUp zamienia szukanie twórców w wyszukiwanie. Wskazujesz jeden profil na TikToku, który już działa dla twojej marki; czteroetapowy pipeline agentowy analizuje ten profil — treści, styl, wątki komentarzy — następnie przesiewa do tysiąca kandydatów i zwraca około dziesięciu ocenionych dopasowań w mniej więcej pięć minut. Etapy są ułożone według kosztu: tanie filtry statystyczne i twarde reguły działają na wszystkich, kosztowna analiza multimodalna tylko na tych, którzy przeszli dalej — dzięki temu jedno wyszukiwanie kosztuje centy, a nie euro. Każdy kandydat ma cztery oceny cząstkowe i pisemne uzasadnienie, bo zespół marketingu musi się z tego wydatku wytłumaczyć.

~5 min
na listę ok. 10 twórców
up to 1,000
profili przesianych na wyszukiwanie
4
etapy pipeline'u, ułożone wg kosztu
Vue.jsNode.jsAI agentsLLM APIsEmbeddingsThird-party data APIs
Przeczytaj studium przypadku
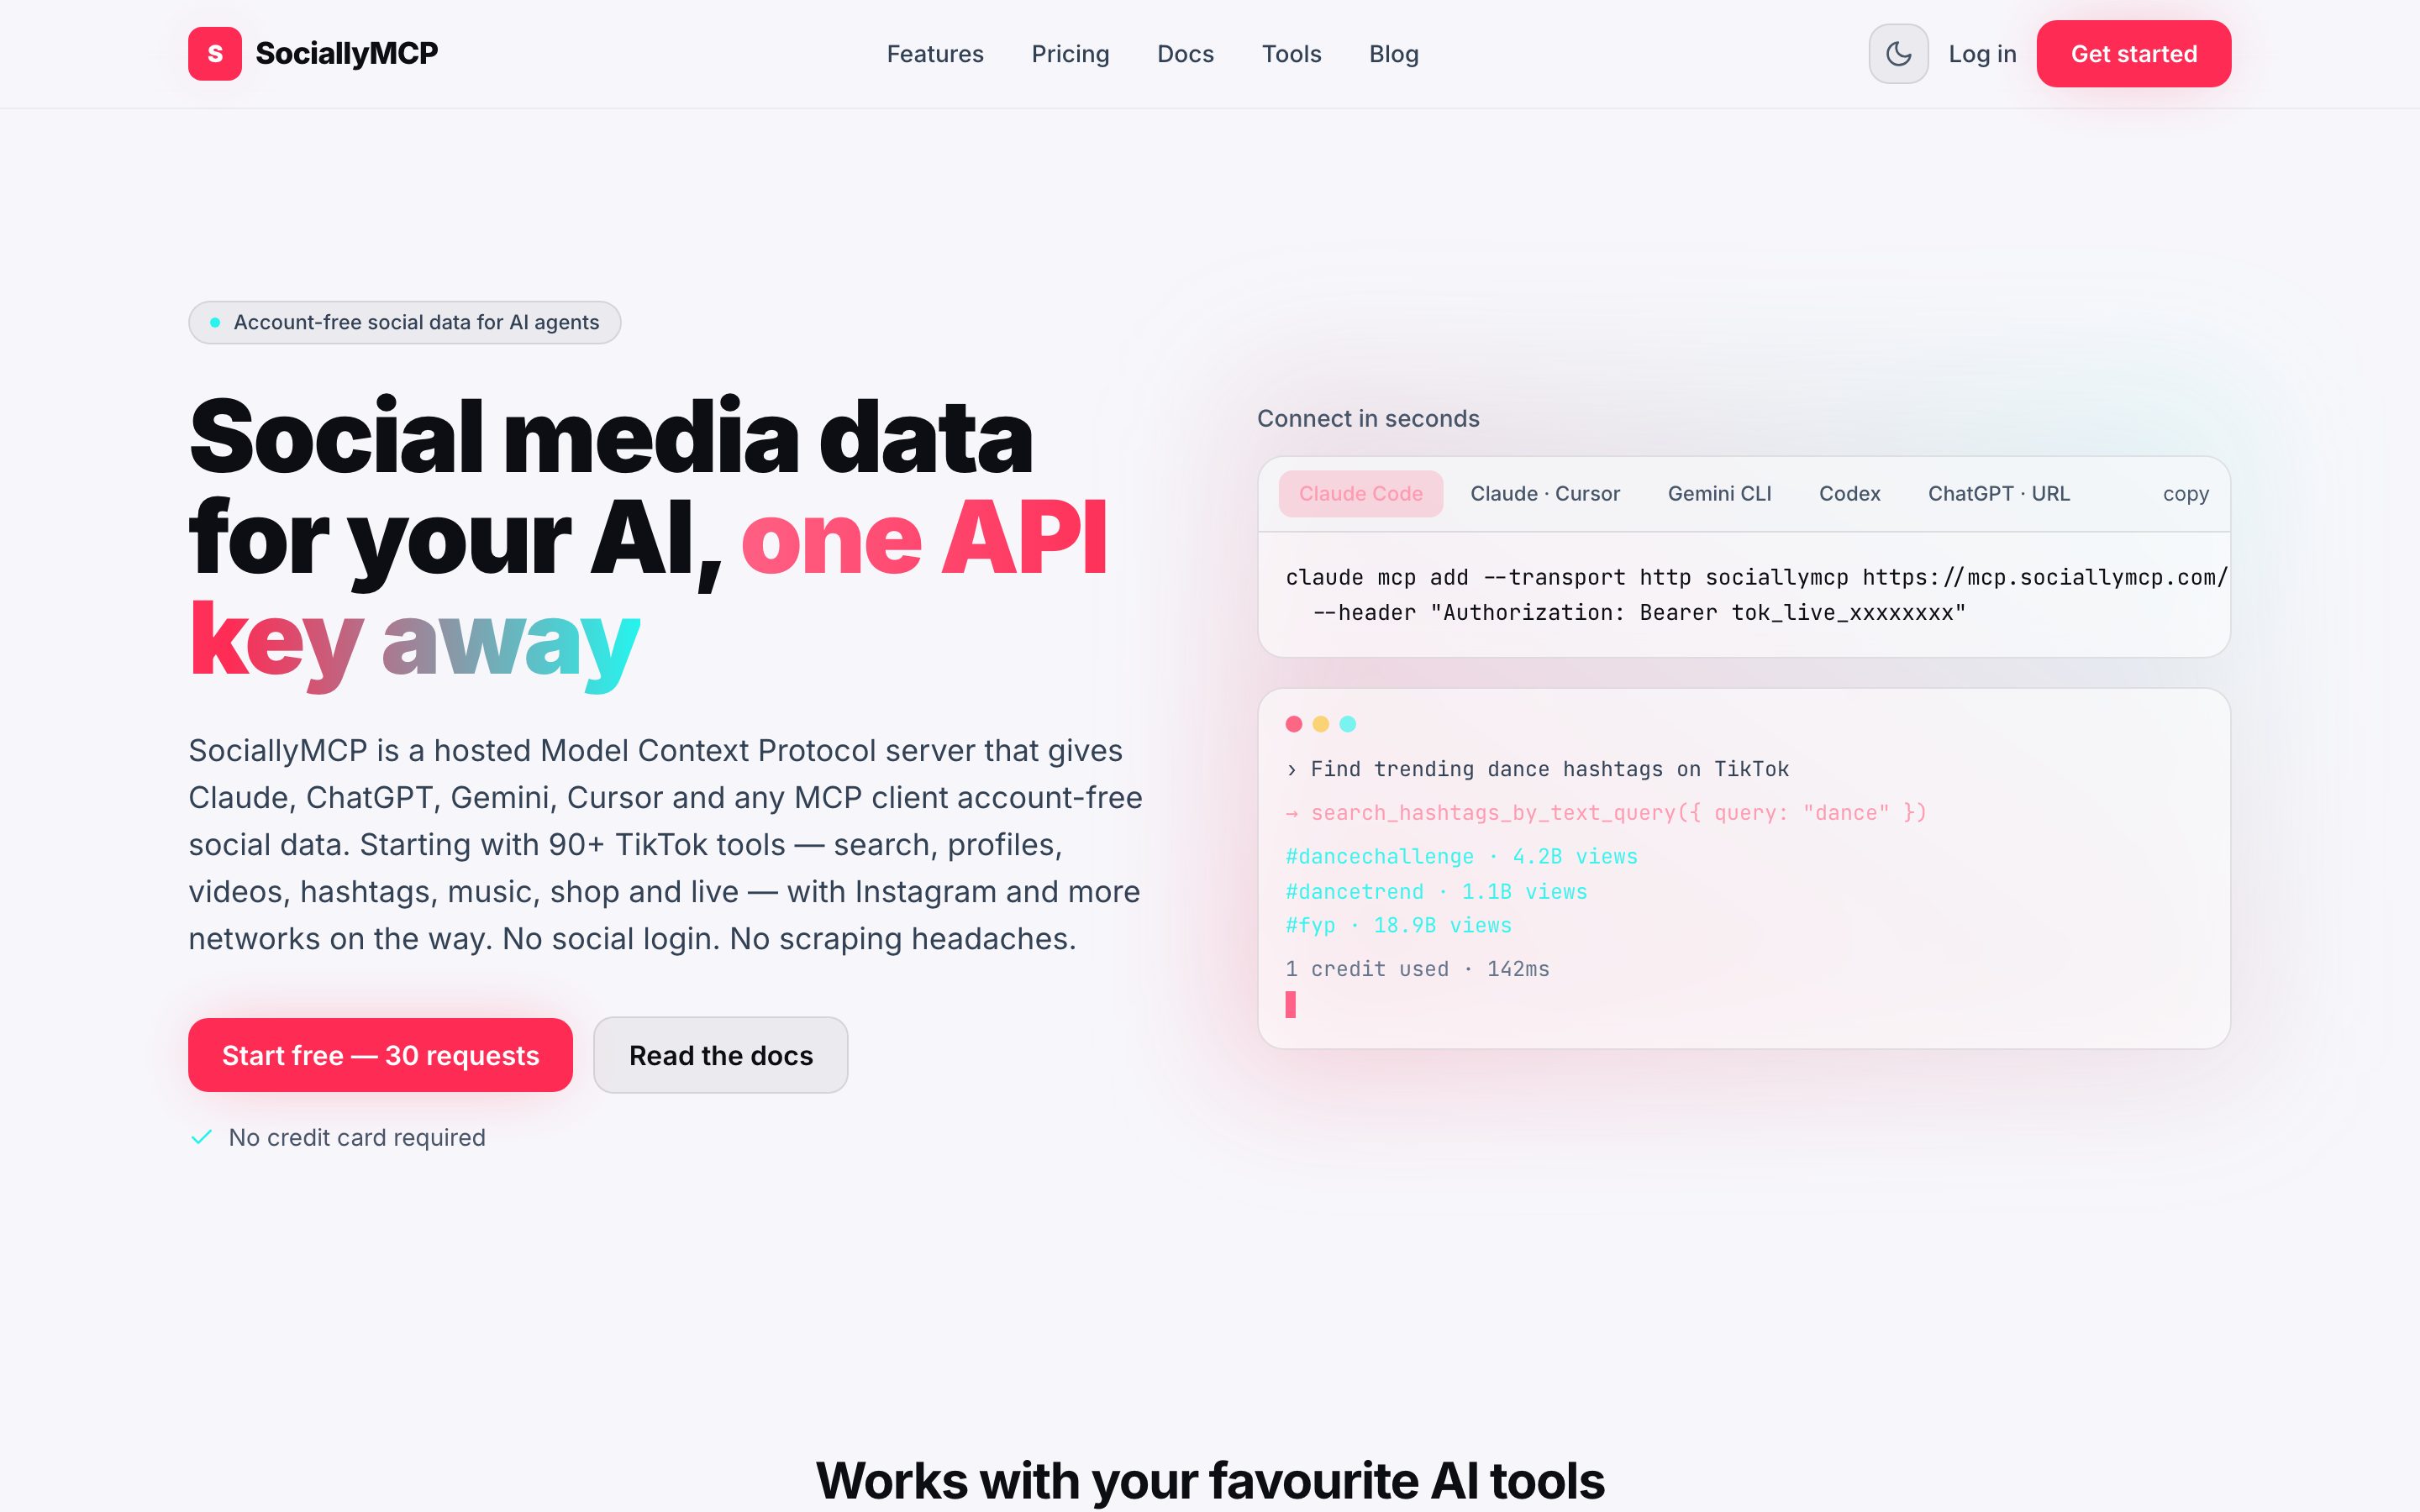
Zrzut ekranu strony głównej SociallyMCP.com
032026

SociallyMCP.com

Działalność gospodarcza

Założyciel · produkt i inżynieria

Dane społecznościowe dla twojego AI, w zasięgu jednego klucza API — bez logowania, bez własnego scrapingu.

SociallyMCP to hostowany serwer Model Context Protocol, który daje Claude, ChatGPT, Gemini, Cursorowi i dowolnemu klientowi MCP dostęp do prawdziwych danych z TikToka — bez logowania do serwisu, bez ciasteczek sesji, bez własnego scrapingu do utrzymywania. Zamiast jednego uniwersalnego endpointu jest ponad 90 wąskich, dobrze otypowanych narzędzi, bo agent trafniej wybiera narzędzie po czytelnej sygnaturze, niż układa poprawne zapytanie do ogólnego API. Źródło danych zostaje za jednym adapterem, ze znormalizowanym JSON-em, więc zmiany po stronie platformy nigdy nie docierają do agenta klienta. Rozliczanie działa w tym samym punkcie: jedno wywołanie, jeden kredyt, z twardym limitem wydatków.

90+
otypowanych narzędzi MCP
$0 → $500
samoobsługowych planów
0 logins
wymaganych logowań społecznościowych
MCPTypeScriptNode.jsStreamable HTTPBearer authMetering
Przeczytaj studium przypadku
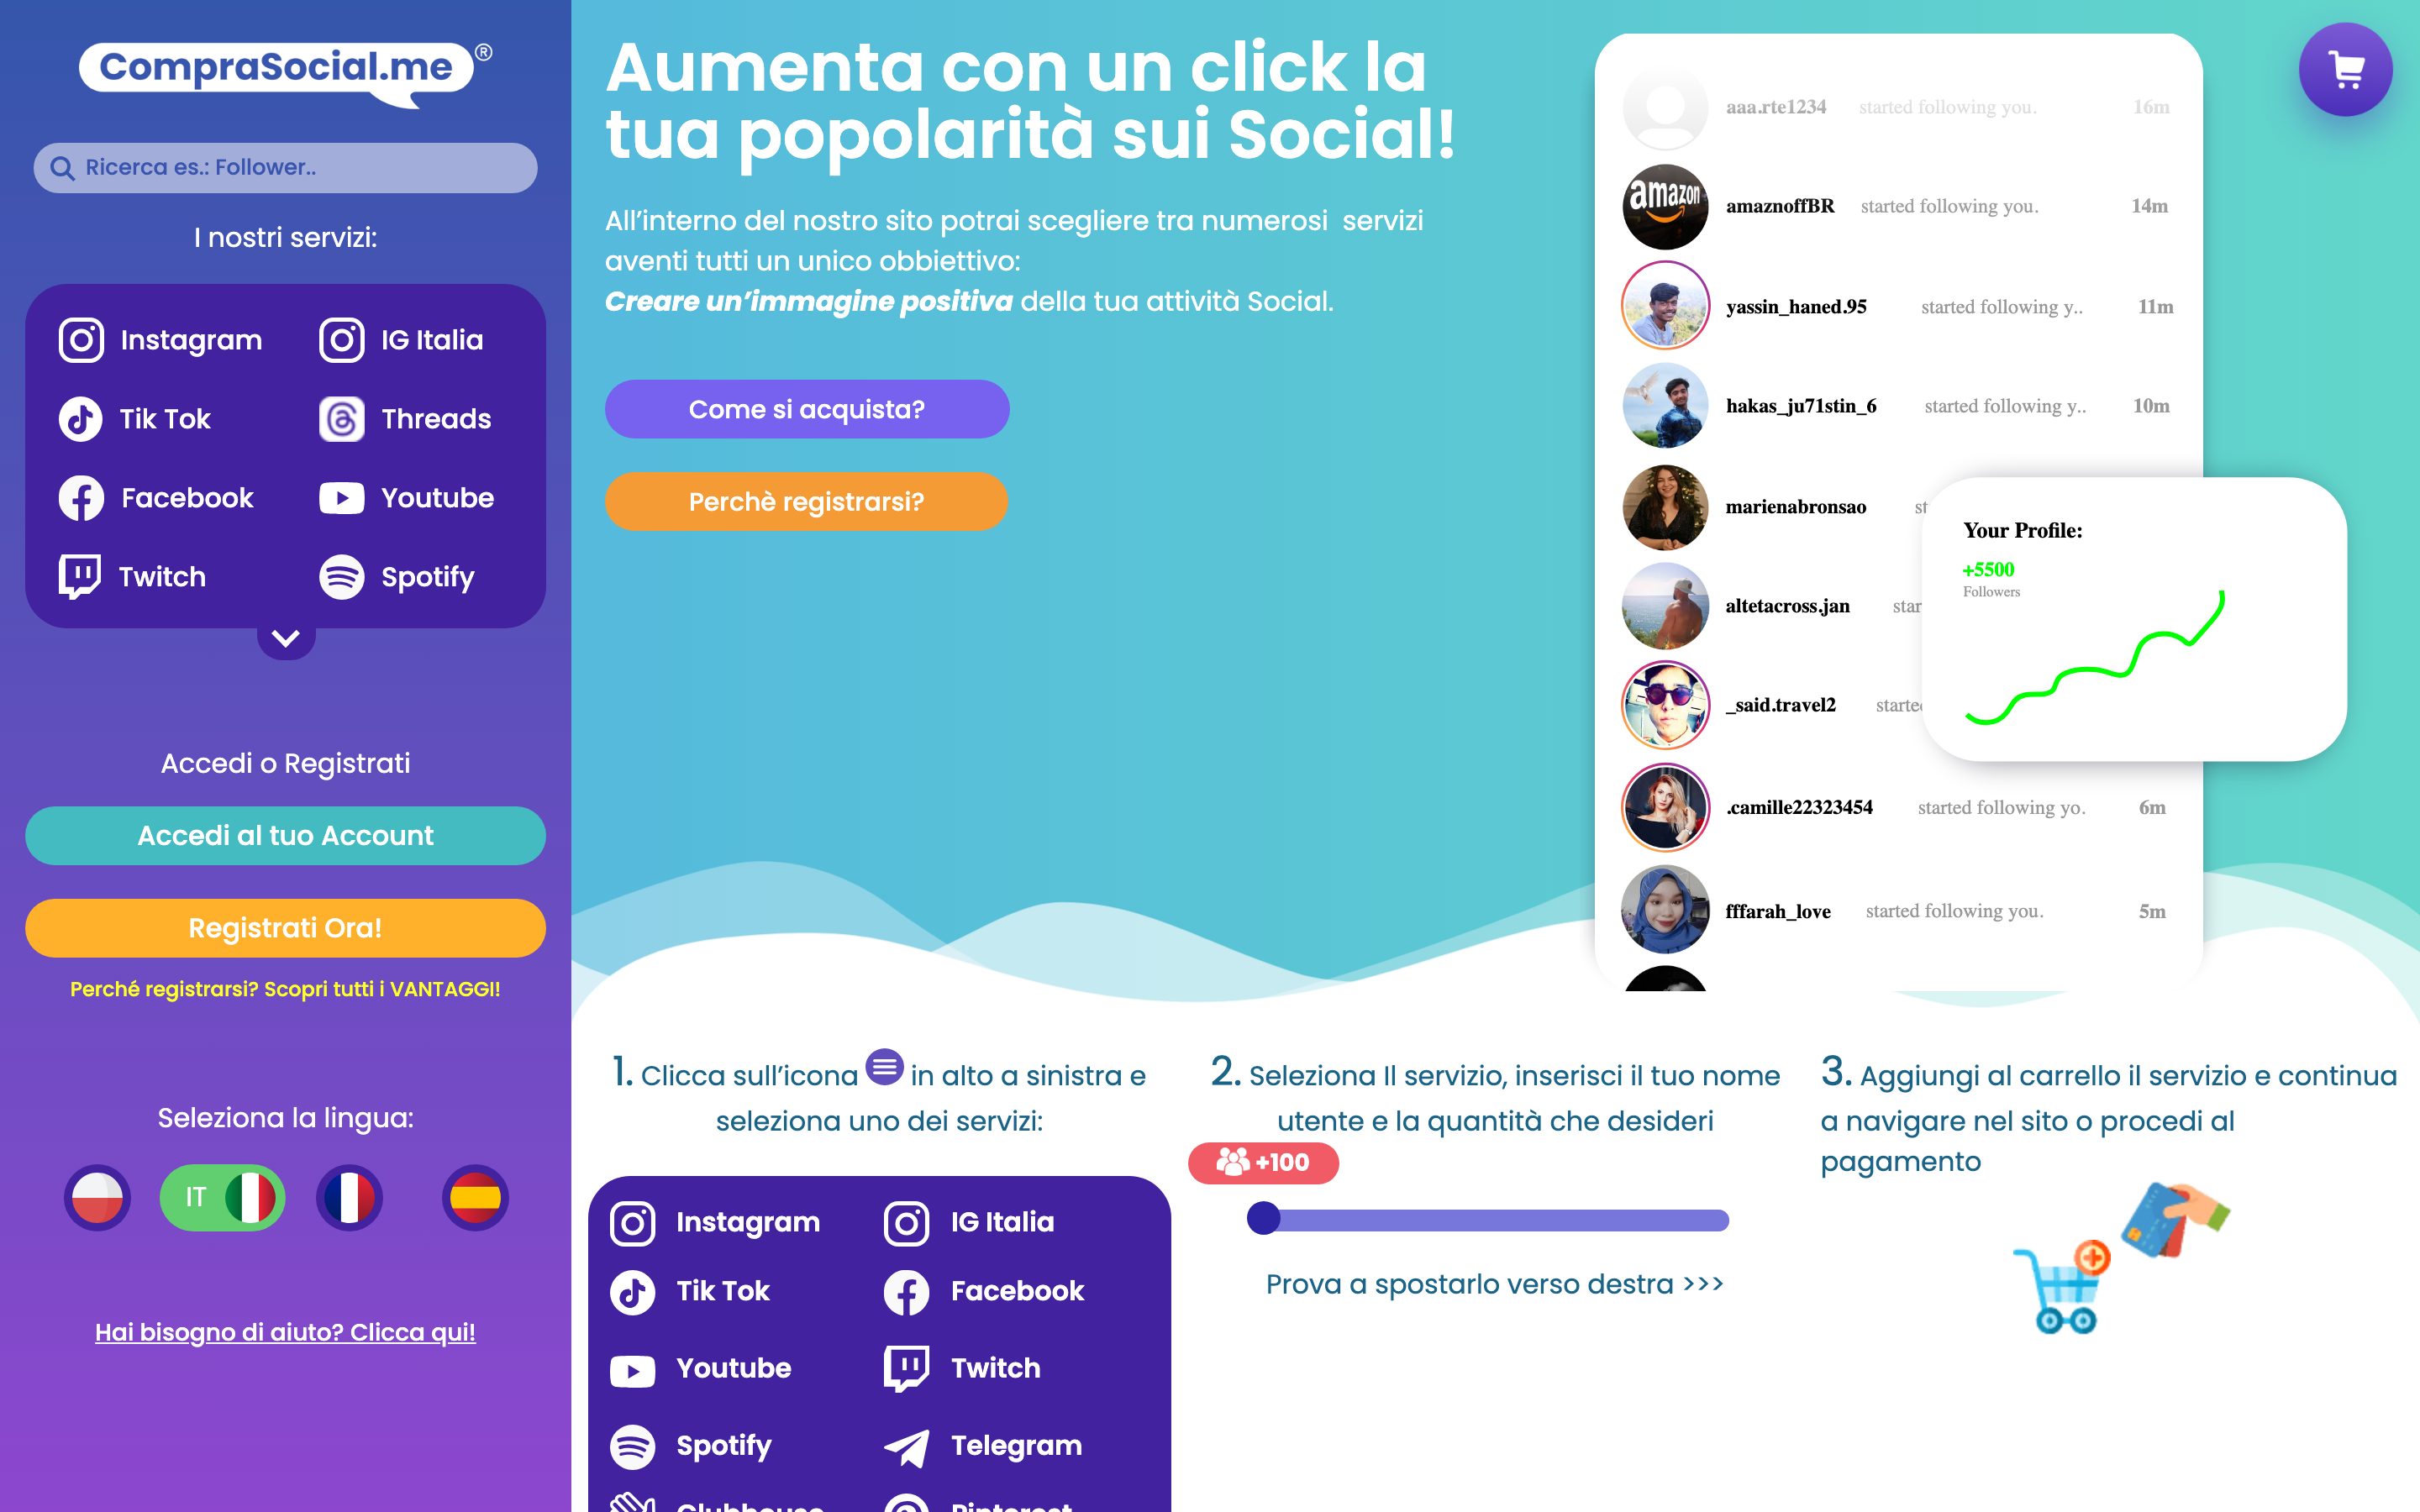
Zrzut ekranu strony głównej CompraSocial.me
042021 — 2026

CompraSocial.me

LumaUp sp. z o.o.

Założyciel · developer · operator

300 000 zamówień, obsługiwanych przez dwie osoby i dużo automatyzacji.

CompraSocial to platforma marketingu społecznościowego, która obsłużyła ponad 300 000 zamówień na jedenastu platformach i w czterech językach — przy zespole dwóch osób. WordPress odpowiada za treść i SEO; interaktywne części — koszyk, panele, przepływy zamówień — to własne komponenty Vue.js na dedykowanym API. Najciekawsze jest to, co pod spodem: każdą powtarzalną czynność ręczną uszeregowałem według godzin tygodniowo i w tej kolejności zautomatyzowałem — od sprawdzania profili i walidacji zamówień po wysyłkę, śledzenie dostawy i aktualizacje statusu. Dziś około 90% codziennych operacji działa bez nadzoru, z alertami tylko na wyjątkach. Zwroty i spory nadal trafiają do człowieka.

300,000+
obsłużonych zamówień
90%
operacji zautomatyzowanych
11
platform społecznościowych
WordPressPHPVue.jsMySQLMongoDBCustom theme
Przeczytaj studium przypadku

Szukasz kogoś, kto ogarnie całość?

Etat, projekt kontraktowy albo architektura, która potrzebuje drugiej pary oczu — opisz kształt sprawy. Jeśli nie jestem właściwą osobą, powiem to od razu.

Napisz do mnie